1
От нейрона к ИИ-агенту: интерактив
Собрал тут интерактивную презентацию про нейронные сети и ИИ-агентов. Начинается с одного нейрона, заканчивается агентской системой. Рассчитана в первую очередь на людей без технической подготовки, но и для тех, кто уже пользуется LLM, там есть что покрутить.
Презентацию можно листать по слайдам или переключить в режим статьи — тогда к схемам добавляются пояснения. Есть русский и английский языки. Если основной сайт не открывается, есть зеркало на GitHub Pages.
В эту статью решил утащить один из примеров. Про нейроны часто рассказывают через картинки со множеством кружочков и линий. Давайте соберём штуку, которую можно проверить буквально на четырёх вариантах входных данных.
Что считает один нейрон
Возьмём два входа: x₁ и x₂. На каждом может быть 0 или 1. Нейрон умножает входы на веса, складывает результаты и добавляет ещё одно число — смещение, или bias:
z = x₁ × w₁ + x₂ × w₂ + biasДальше применяем "функцию активации": если сумма получилась не меньше нуля, на выходе будет 1. Иначе 0. Это пороговая функция. В более сложных сетях функции активации другие, но для нашего примера такой ступеньки достаточно.
Допустим, оба веса равны 1, а bias равен −1,5. Если включён только один вход, сумма будет −0,5 — нейрон выдаст 0. Если оба, получим 0,5 и на выходе 1. Получилась логическая операция AND: результат истинен, когда истинны оба входа.
Ниже — тот самый пример из презентации. Выберите AND, OR или NOT, нажимайте на входы и смотрите, как меняются сумма и результат. Потом переключитесь на XOR: схема станет чуть интереснее.
Логические операции на нейронах
Выберите операцию и переключайте входы 0 / 1.
Таблица истинности
| x₁ | x₂ | AND | OR | NOT x₁ | XOR |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 1 | 0 |
| 0 | 1 | 0 | 1 | 1 | 1 |
| 1 | 0 | 0 | 1 | 0 | 1 |
| 1 | 1 | 1 | 1 | 0 | 0 |
Веса здесь выставлены вручную. Блок ничего не обучает и никуда не отправляет данные — просто пересчитывает несколько чисел прямо в браузере.
Почему для XOR понадобилось три нейрона
XOR выдаёт 1, когда входы разные: 0, 1 или 1, 0. Если они одинаковые, результат 0. Один пороговый нейрон с двумя входами и взвешенной суммой так не умеет. Если нарисовать четыре варианта входов на плоскости, одной прямой не получится отделить две нужные точки от двух остальных.
Добавим скрытый слой. Один нейрон считает OR — включён ли хотя бы один вход. Второй считает AND — включены ли оба. Выходной нейрон получает уже эти два результата:
h₁ = OR(x₁, x₂)
h₂ = AND(x₁, x₂)
z = h₁ − 2 × h₂ − 0,5
Если включён ровно один вход, h₁ = 1, h₂ = 0, и сумма на выходе равна 0,5. Получаем 1. Если включены оба, второй нейрон тоже срабатывает и вычитает из суммы двойку. Получаем −1,5 и результат 0. Ну а с двумя нулями первый нейрон не сработает вообще.
Это уже маленькая нейронная сеть с тремя нейронами, но все вычисления логичны и понятны.
Откуда берутся веса
Другой пример. Здесь мы заранее знаем нужные числа. Но вручную расставлять коэффициенты между пикселями и ответом неэффективно (хотя и возможно).
При обучении сети показывают примеры с известными ответами. Алгоритм обратного распространения ошибки вычисляет, как веса влияют на ошибку, а алгоритм оптимизации немного корректирует их. Процесс многократно повторяется на всём наборе данных.
Следующий пример в презентации — распознавание цифр на сетке 3×5. Можно менять пиксели и смотреть, как меняются оценки для десяти цифр. Там уже 634 обучаемых параметра: 600 весов и 34 смещения. Для сравнения — у больших языковых моделей число параметров может исчисляться сотнями миллиардов. Например, у DeepSeek-V3 их 671 млрд, а на каждый токен активируются 37 млрд. Остальные тоже входят в сеть, просто не участвуют в каждом шаге.
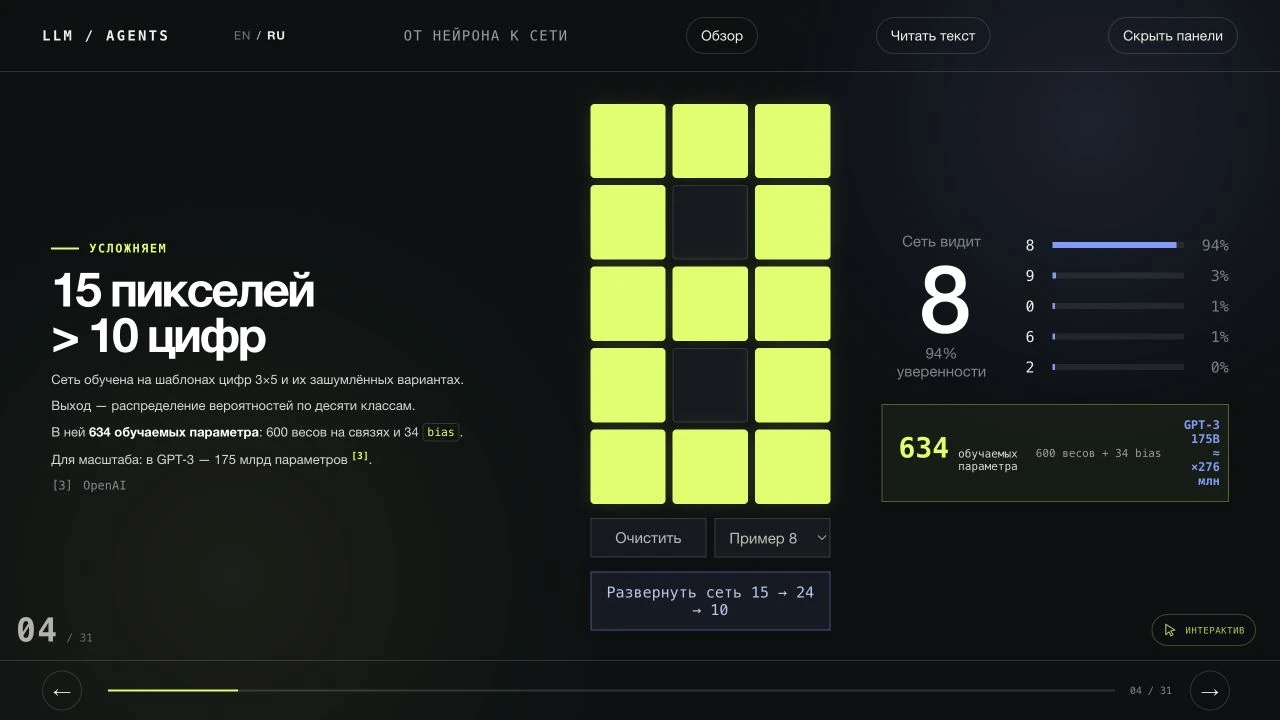
15 пикселей на входе, десять вариантов ответа на выходе. Попробовать в презентации.
Как отсюда дойти до агента
Дальше в презентации идём от чисел к тексту. Текст разбивается на токены, токены превращаются в числовые представления. Transformer использует механизм attention, чтобы учитывать связи между позициями в контексте. При генерации языковая модель вычисляет распределение для следующего токена, выбирается один из вариантов, и процесс повторяется.
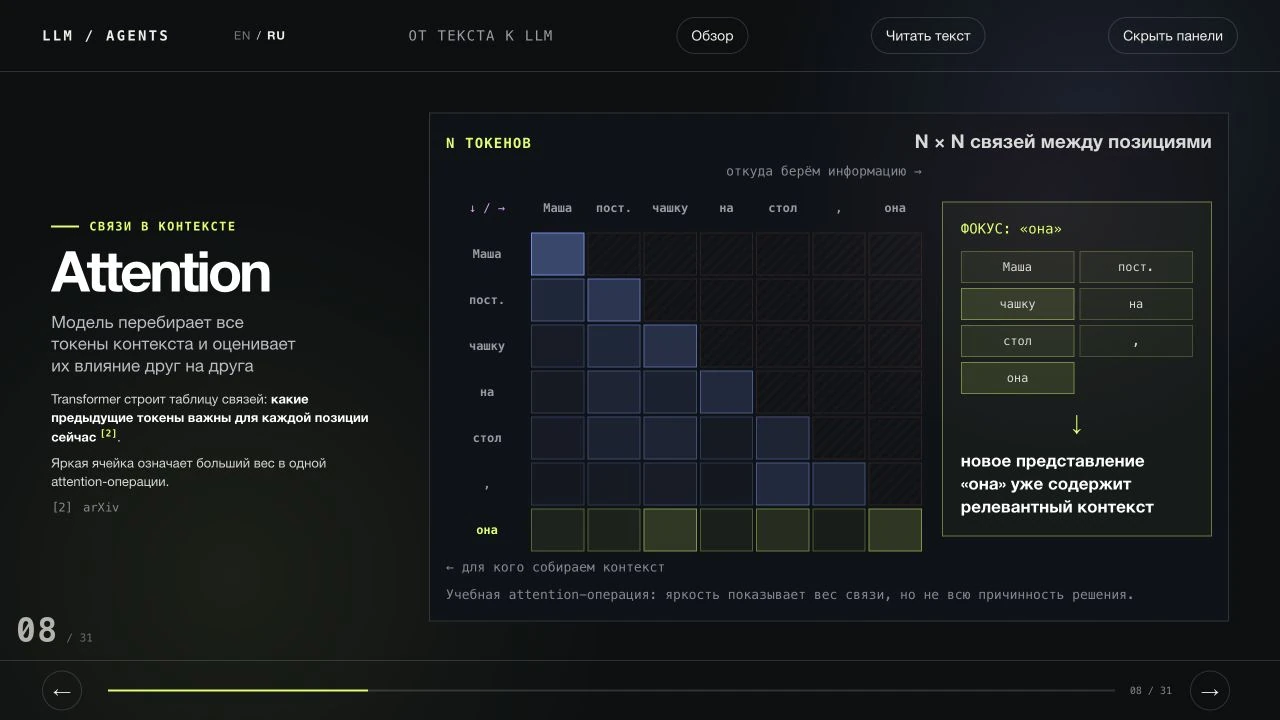
Яркость ячейки показывает вес связи в одной операции. Открыть слайд.
Само по себе это ещё не запускает терминал и не меняет файлы. Для этого вокруг модели нужна программа под названием harness. Она передаёт модели задачу и доступные инструменты, выполняет запрошенные вызовы, возвращает результаты и поддерживает следующий шаг. В итоге мы имеем агента, который может, например, прочитать проект, внести изменение, запустить тест и увидеть ошибку.
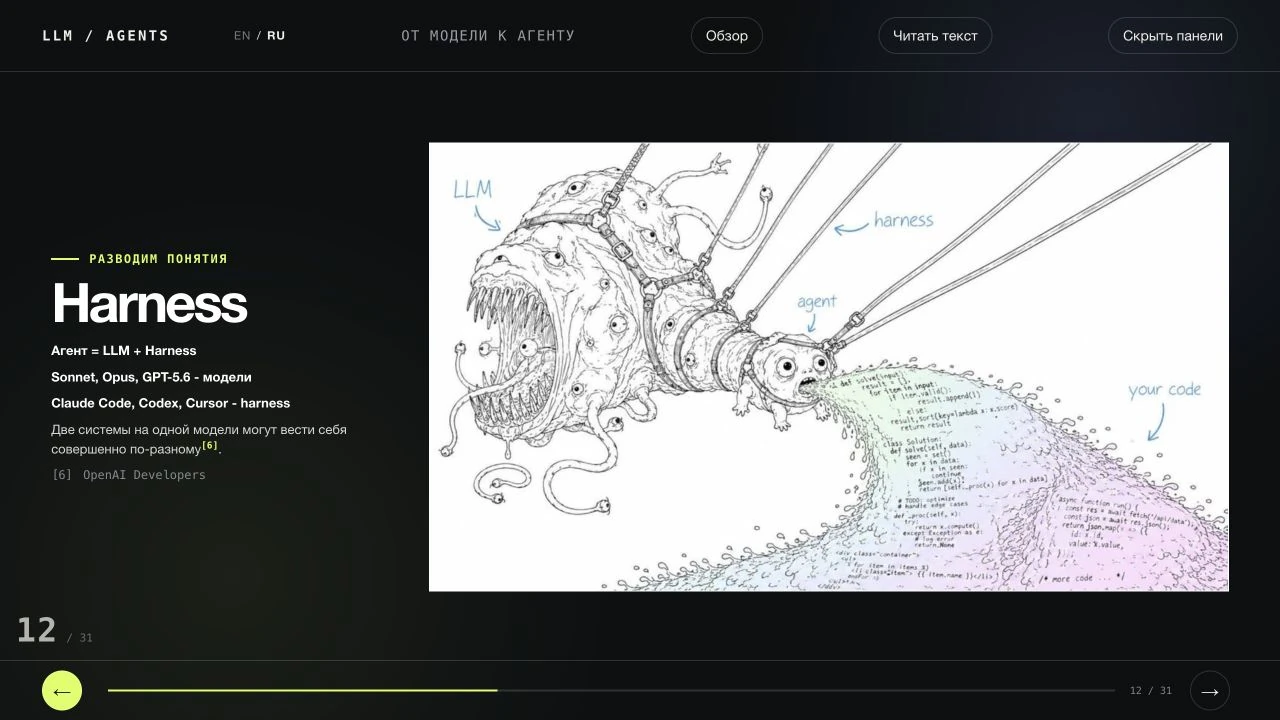
Та самая обвязка вокруг модели. Слайд про harness.
В презентации есть отдельные блоки про этот цикл, контекст, инструменты и мой рабочий процесс. А в бонусном разделе — устройство Transformer уже с формулами. Туда можно идти, когда хочется разобраться глубже; для переключения трёх нейронов выше матан не понадобился.
Открыть всё целиком можно здесь. Начать советую с входов в XOR: включите оба и посмотрите, какой именно нейрон выключит результат.
Комментариев пока нет
-

Продолжаем печать после отключения
Печать идет больше суток и в процессе пропадает свет. Знакомо? -

Как я работу в 2026 году менял + бонус
После 10 лет в e-commerce я вышел на рынок -

Goback - простые бэкапы
Решил тут наконец заняться бэкапами. И без самописных утилит не обошлось. -

Проект Наблюдатель
Проект приурочен к хеллоуину - это статуя одноглазого ктулху с механизированным… -

Универсальный AI Telegram Bot
Хотите в пару действий запустить собственного AI бота для Telegram? -

Анализ истории просмотров Youtube
Задумывались, сколько времени вы проводите за просмотром видео? Давайте считать.